

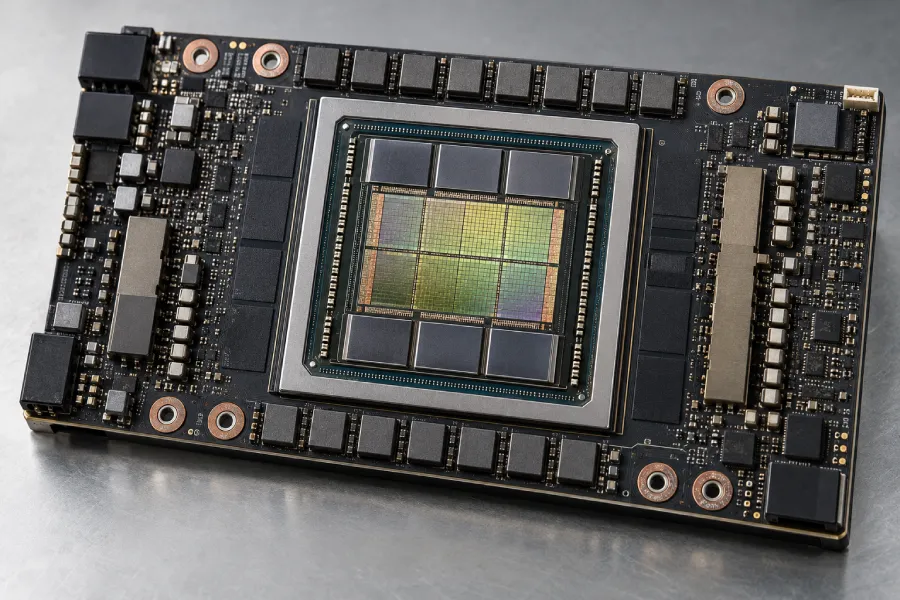
Les GPU utilisés pour l’intelligence artificielle peuvent exécuter d’immenses volumes d’opérations en parallèle. Cette puissance n’est réellement exploitable que si les données arrivent suffisamment vite jusqu’aux unités de calcul et si plusieurs GPU peuvent échanger leurs résultats sans passer une part excessive de leur temps à attendre.
C’est l’une des raisons pour lesquelles la mémoire HBM, pour High Bandwidth Memory, est devenue un composant stratégique des accélérateurs d’IA. Elle rapproche une mémoire à très haut débit des dies de calcul.
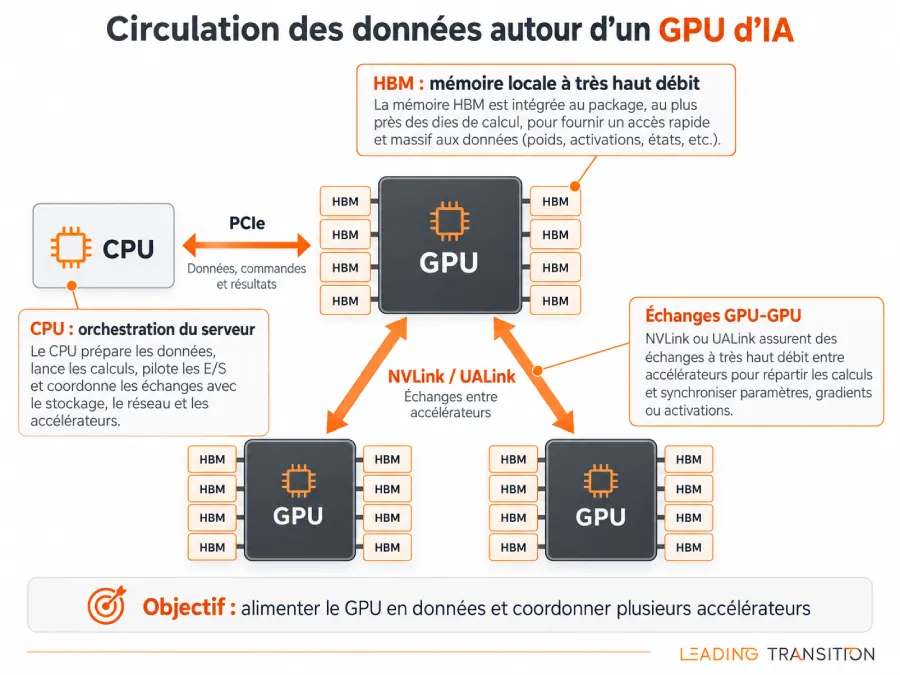
Lorsque plusieurs GPU travaillent ensemble, une autre problèmatique apparaît : les données doivent aussi circuler entre les accélérateurs. PCIe, Infinity Fabric, NVLink ou UALink interviennent alors à différentes échelles de l’architecture.
Dans une infrastructure d’IA, la performance dépend donc autant de la capacité à déplacer l’information que de la vitesse à laquelle les GPU savent la traiter.
Sommaire
- Qu’est-ce que la mémoire HBM et pourquoi les GPU d’IA en ont-ils besoin ?
- Comment fonctionne la mémoire HBM ?
- Capacité, bande passante et latence : comment lire les performances de la mémoire GPU ?
- Pourquoi plusieurs GPU doivent-ils échanger autant de données ?
- PCIe, NVLink, Infinity Fabric et UALink : des interconnexions pour des besoins différents
- Gb/s, Go/s et bande passante agrégée : comment comparer les interconnexions GPU ?
Qu’est-ce que la mémoire HBM et pourquoi les GPU d’IA en ont-ils besoin ?
HBM signifie High Bandwidth Memory, littéralement « mémoire à large bande passante ». Cette famille de mémoires est conçue pour fournir rapidement de grandes quantités de données à des processeurs dont les capacités de calcul dépassent ce qu’une interface mémoire conventionnelle peut alimenter efficacement.
Or, c’est ce qui se produit souvent avec les GPU. Des milliers d’unités peuvent effectuer des opérations simultanément. Chacune a besoin de lire des données, puis d’écrire des résultats. Si le processeur attend régulièrement que la mémoire lui fournisse ces informations, une partie des unités de calcul reste inutilisée.
On parle alors d’une charge memory-bound : la limitation principale ne vient plus de la capacité arithmétique du GPU, mais du rythme auquel les données peuvent lui être fournies.
Pour comprendre comment l’architecture du GPU, les unités de calcul et la bande passante mémoire interagissent, voir notre article sur le fonctionnement d’un GPU.
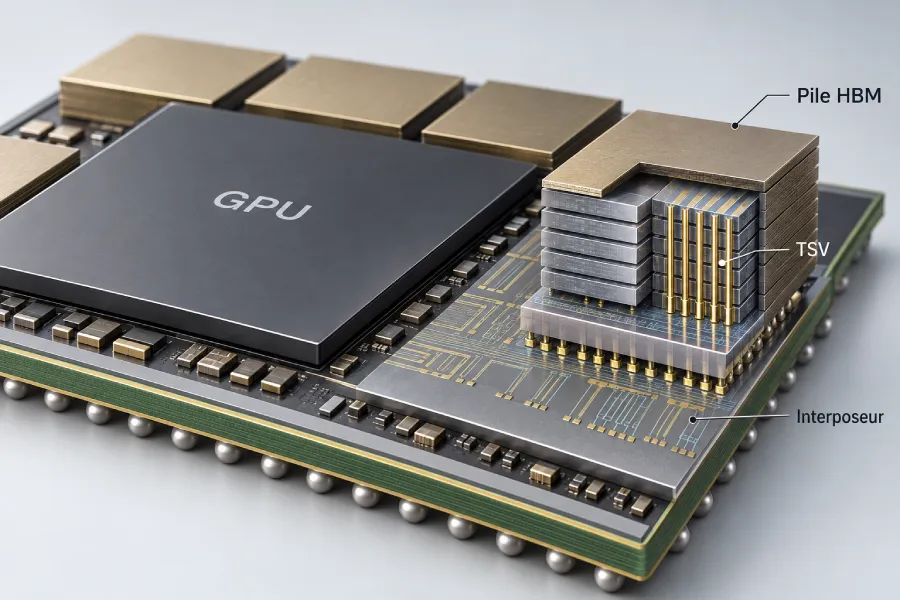
La HBM répond à cette contrainte par une architecture spécifique. Plusieurs dies de mémoire sont empilés verticalement et installés au plus près des dies de calcul, avec une interface beaucoup plus large que celle d’une mémoire conventionnelle.
Cette organisation permet à un accélérateur d’accéder simultanément à un très grand nombre de lignes de données. Elle réduit aussi les distances électriques entre mémoire et processeur.
L’enjeu est particulièrement important pour l’intelligence artificielle. Les poids d’un modèle, les activations produites pendant le calcul ou différentes données intermédiaires doivent pouvoir être lues et écrites à un rythme compatible avec les capacités du GPU.
La HBM ne constitue donc pas seulement une réserve de mémoire supplémentaire. Elle fait partie de l’architecture qui permet aux unités de calcul d’être effectivement utilisées.
Comment fonctionne la mémoire HBM ?
Une mémoire HBM se distingue d’abord par son organisation verticale.
Au lieu d’aligner plusieurs composants DRAM les uns à côté des autres sur un circuit imprimé, les fabricants superposent plusieurs dies de mémoire. Une pile HBM occupe ainsi une surface relativement réduite à proximité immédiate du processeur tout en regroupant plusieurs couches de DRAM.
Cette proximité réduit les distances électriques à parcourir. Surtout, elle permet d’utiliser une interface beaucoup plus large entre la mémoire et le système de calcul.
Des dies de DRAM empilés verticalement
Les circuits de mémoire sont fabriqués sur des wafers de silicium. Après les étapes de fabrication et de test, les dies utilisables sont amincis puis assemblés en couches superposées.
Certaines HBM4 commercialisées ou échantillonnées en 2026 utilisent douze dies de DRAM empilés, avec des versions à seize couches prévues ou en cours de développement selon les fabricants.
Cet empilement impose de faire circuler les signaux électriques entre les différentes couches sans multiplier les connexions latérales.
C’est le rôle des TSV, pour Through-Silicon Vias.
Un TSV est une connexion électrique verticale traversant le silicium. Des milliers de ces liaisons peuvent relier les différents dies d’une même pile et assurer le transport des données à travers l’empilement.
À la base de la pile, un die d’interface ou une logique dédiée assure les communications avec le reste du système.
La fabrication devient plus exigeante à mesure que le nombre de couches augmente. Les dies doivent être suffisamment fins, correctement alignés et reliés avec une grande précision. Un défaut affectant une couche ou une liaison peut réduire le rendement de l’ensemble.
La HBM dépend donc directement des progrès du packaging avancé et de l’intégration tridimensionnelle.
Une interface très large pour transporter davantage de données
La HBM n’obtient pas ses performances uniquement en augmentant la fréquence des signaux. Son architecture repose aussi sur un très grand nombre de voies capables de transporter des données simultanément.
HBM4 porte ainsi la largeur de son interface à 2 048 lignes d’E/S. Certaines piles dépassent 2,8 To/s de bande passante théorique.
Cette approche rappelle en quelque sorte celle du GPU lui-même : une partie des performances est obtenue en multipliant les voies capables de travailler simultanément.
Les piles HBM sont ensuite placées très près des dies de calcul à l’aide de technologies de packaging avancé.
Un interposeur en silicium ou d’autres structures de redistribution permettent de créer un nombre très élevé de connexions entre la mémoire et les différents dies du processeur. Les données n’ont alors pas à parcourir de longues pistes sur une carte électronique classique.
Cette proximité physique constitue une partie essentielle de l’architecture HBM. La mémoire, le packaging et le GPU forment désormais un ensemble étroitement intégré.
Capacité, bande passante et latence : comment lire les performances de la mémoire GPU ?
Les fiches techniques des accélérateurs présentent plusieurs caractéristiques liées à la mémoire. Elles ne mesurent pas la même chose.
- La capacité, exprimée en Go, indique la quantité de données pouvant être conservée simultanément dans la mémoire.
- La bande passante, exprimée en Go/s ou en To/s, mesure la quantité maximale de données susceptible de circuler pendant une seconde.
- La latence correspond au délai nécessaire entre une demande d’accès et l’arrivée effective de la donnée.
Une mémoire peut donc disposer d’une capacité importante sans offrir la bande passante la plus élevée. À l’inverse, une interface très rapide ne signifie pas que le GPU dispose d’un volume de mémoire suffisant pour tous les modèles.
Les accélérateurs récents illustrent bien cette distinction.
Le NVIDIA Rubin associe jusqu’à 288 Go de HBM4 à une bande passante mémoire maximale annoncée d’environ 22 To/s.
L’AMD Instinct MI455X atteint 432 Go de HBM4 répartis sur douze piles, avec une bande passante maximale annoncée de 23,3 To/s.
Les nombres exprimés en Go décrivent donc la capacité. Ceux exprimés en To/s décrivent le débit de l’interface mémoire.
La valeur publiée par le constructeur reste cependant un maximum théorique.
Le débit réellement obtenu par une application dépend de la manière dont les données sont organisées, de la taille des accès, de l’utilisation des caches et de la capacité du logiciel à réutiliser des données déjà transférées.
Une application qui lit continuellement de nouvelles informations dans la HBM exploitera la mémoire différemment d’un calcul capable de conserver temporairement ses données près des unités de calcul et de les réutiliser plusieurs fois.
C’est pourquoi deux programmes utilisant le même GPU peuvent atteindre des niveaux de performance très différents, même lorsque la bande passante théorique de la mémoire reste identique.
Cette contrainte prend une autre dimension lorsque les données nécessaires au calcul ne se trouvent plus dans la HBM du GPU qui doit les traiter.
Pourquoi plusieurs GPU doivent-ils échanger autant de données ?
Un accélérateur moderne dispose d’une puissance de calcul et d’une quantité de mémoire importantes. Certains modèles ou entraînements dépassent néanmoins les ressources d’un seul GPU.
Le travail doit alors être distribué entre plusieurs accélérateurs.
Dans une forme courante de parallélisme de données, plusieurs GPU possèdent chacun une copie du modèle et travaillent sur des lots de données différents.
Chaque GPU calcule localement les gradients nécessaires à l’apprentissage. Ces résultats doivent ensuite être combinés afin que les différentes copies du modèle restent synchronisées.
Une opération appelée All-Reduce permet notamment de réaliser cette synchronisation.
Chaque GPU fournit ses résultats partiels. Ceux-ci sont combinés, puis le résultat obtenu est rendu disponible aux différents participants.
All-Reduce appartient à une famille plus large d’opérations collectives utilisées dans le calcul distribué.
All-Gather permet par exemple de réunir sur plusieurs participants des fragments de données auparavant répartis. Reduce-Scatter combine au contraire certaines valeurs avant d’en redistribuer différentes parties.
Ces échanges deviennent encore plus importants lorsque le modèle lui-même est réparti entre plusieurs GPU.
Dans certaines méthodes de sharding, chaque accélérateur ne conserve qu’une partie des paramètres. D’autres fragments doivent être récupérés pendant le calcul, puis certains résultats sont à nouveau redistribués.
Répartir le modèle réduit ainsi la quantité de mémoire nécessaire sur chaque GPU, mais augmente les communications entre les accélérateurs.
Le temps consacré aux échanges devient alors une composante directe du temps de calcul.
Un GPU peut terminer ses opérations locales rapidement puis rester inutilisé pendant qu’il attend une information produite par un autre accélérateur.
Les logiciels de calcul distribué cherchent à réduire ce temps en faisant chevaucher calcul et communication. Certaines opérations collectives peuvent ainsi démarrer pendant que d’autres calculs sont encore en cours.
Cette optimisation ne supprime toutefois pas la contrainte physique. À mesure que le nombre de GPU et la quantité de données échangées augmentent, la bande passante et la latence de l’interconnexion deviennent déterminantes.
PCIe, NVLink, Infinity Fabric et UALink : des interconnexions pour des besoins différents
Les données circulant autour d’un GPU n’empruntent pas toutes les mêmes chemins.
À l’intérieur du package, il faut relier les différents dies qui composent l’accélérateur.
Dans un serveur, le GPU doit communiquer avec le CPU, les cartes réseau ou d’autres périphériques.
Lorsque plusieurs GPU travaillent ensemble, des interconnexions spécialisées assurent les échanges directs entre accélérateurs.
Ces différentes technologies ne doivent donc pas être considérées comme des concurrents interchangeables.
Infinity Fabric est utilisé par AMD à l’intérieur de certaines architectures pour relier les différents chiplets, caches, contrôleurs mémoire et fonctions d’entrées-sorties.
Son rôle se situe au plus près de l’accélérateur lui-même.
PCI Express, ou PCIe, est une interface standardisée utilisée pour connecter CPU, GPU et périphériques dans un serveur.
Elle constitue une infrastructure générale de communication entre composants et bénéficie d’une très large compatibilité matérielle.
NVLink répond à un besoin plus spécialisé. NVIDIA l’utilise pour créer des liaisons à très haut débit entre GPU et permettre à plusieurs accélérateurs de travailler au sein d’un même domaine de calcul.
Des switches NVLink peuvent relier un nombre important de GPU sans obliger toutes les communications à repasser par le CPU.
UALink poursuit un objectif similaire de communication directe entre accélérateurs, mais sous la forme d’un standard ouvert porté par un consortium industriel.
Il définit des liens et des architectures de switches destinés aux systèmes dits scale-up, dans lesquels plusieurs accélérateurs doivent fonctionner comme une ressource de calcul étroitement interconnectée.
| Technologie | Fonction caractéristique | Échelle principale |
|---|---|---|
| AMD Infinity Fabric | Relier différents composants d’une architecture AMD | Package / accélérateur |
| PCI Express | Relier CPU, GPU et périphériques | Serveur |
| NVIDIA NVLink | Assurer des communications GPU-GPU à très haut débit | Serveur / rack |
| UALink | Interconnecter des accélérateurs et switches selon un standard ouvert | Domaine scale-up |
Le choix d’une interconnexion dépend donc autant de sa fonction que de son débit.
Comparer les performances de ces technologies nécessite ensuite de regarder précisément les unités et le périmètre des chiffres publiés.
Gb/s, Go/s et bande passante agrégée : comment comparer les interconnexions GPU ?
Les caractéristiques des interconnexions utilisent plusieurs unités qu’il est facile de confondre.
Le bit, noté b, constitue l’unité élémentaire d’information numérique.
L’octet, noté o en français ou B dans les documentations anglophones, correspond à huit bits.
La relation de base est donc : 8 bits = 1 octet
Un débit de 800 Gb/s correspond théoriquement à : 800 ÷ 8 = 100 Go/s
Cette conversion indique uniquement le rapport entre les unités. Elle ne garantit pas qu’une application pourra transférer 100 Go de données utiles chaque seconde.
Une partie du débit peut être utilisée par l’encodage, la correction d’erreurs, les en-têtes de protocole ou d’autres mécanismes nécessaires au fonctionnement de la liaison.
Il faut également vérifier dans quelle direction le débit est mesuré.
Une liaison peut transmettre et recevoir simultanément. Une documentation peut indiquer une valeur dans chaque direction ou, au contraire, publier la somme des deux.
UALink 200G prévoit par exemple des liens pouvant utiliser plusieurs lanes et atteindre 800 Gb/s en émission et 800 Gb/s en réception pour certaines configurations à quatre lanes.
NVLink 6 atteint de son côté jusqu’à 3,6 To/s de bande passante bidirectionnelle par GPU sur les architectures Rubin.
Ces deux valeurs ne peuvent être comparées directement sans vérifier le nombre de liens, de lanes et le périmètre exact de la mesure.
L’échelle de calcul constitue un autre piège.
PCIe 6.0 peut fournir jusqu’à 256 Go/s sur une liaison x16 en additionnant les deux directions selon la convention employée dans sa documentation.
Un GPU Rubin dispose pour sa part de plusieurs téraoctets par seconde de bande passante NVLink.
À l’échelle d’un rack NVIDIA NVL72, la bande passante NVLink agrégée atteint environ 260 To/s.
Ce dernier chiffre ne correspond évidemment ni à la bande passante mémoire d’un GPU, ni à la vitesse d’une seule liaison. Il additionne les capacités d’interconnexion de l’ensemble du domaine.
Le même raisonnement doit être appliqué à la HBM.
Une pile HBM4 peut dépasser 2,8 To/s, tandis qu’un accélérateur équipé de plusieurs piles affiche une bande passante mémoire cumulée beaucoup plus élevée.
Il faut donc toujours identifier si le constructeur parle :
- d’une lane ;
- d’un lien ;
- d’un GPU ;
- d’une pile mémoire ;
- ou d’un ensemble complet de GPU.
La bande passante théorique doit enfin être distinguée du débit réellement obtenu par une application.
La taille des transferts, les protocoles, la topologie des connexions et le logiciel influencent la quantité de données utiles effectivement transportée.
La latence reste également importante. Une très forte bande passante n’efface pas le délai nécessaire à chaque échange.
Ce point devient particulièrement sensible lorsque des milliers ou des millions d’échanges courts sont effectués au cours d’un calcul distribué.
La topologie du système intervient alors directement dans les performances. Certains réseaux sont organisés pour limiter le nombre d’étapes nécessaires entre deux GPU et fournir des chemins de communication aussi homogènes que possible.
Lorsque les distances augmentent encore au-delà de ces domaines de calcul fortement intégrés, transporter toujours plus de données par des liaisons électriques devient plus contraignant. C’est à cette autre échelle que les technologies optiques et la photonique sur silicium prennent progressivement une importance stratégique.